2026年10月15日,我在西安参加石油化工智能化成果应用专题交流会,本文是我做的一次报告的主要内容。
一、研究背景
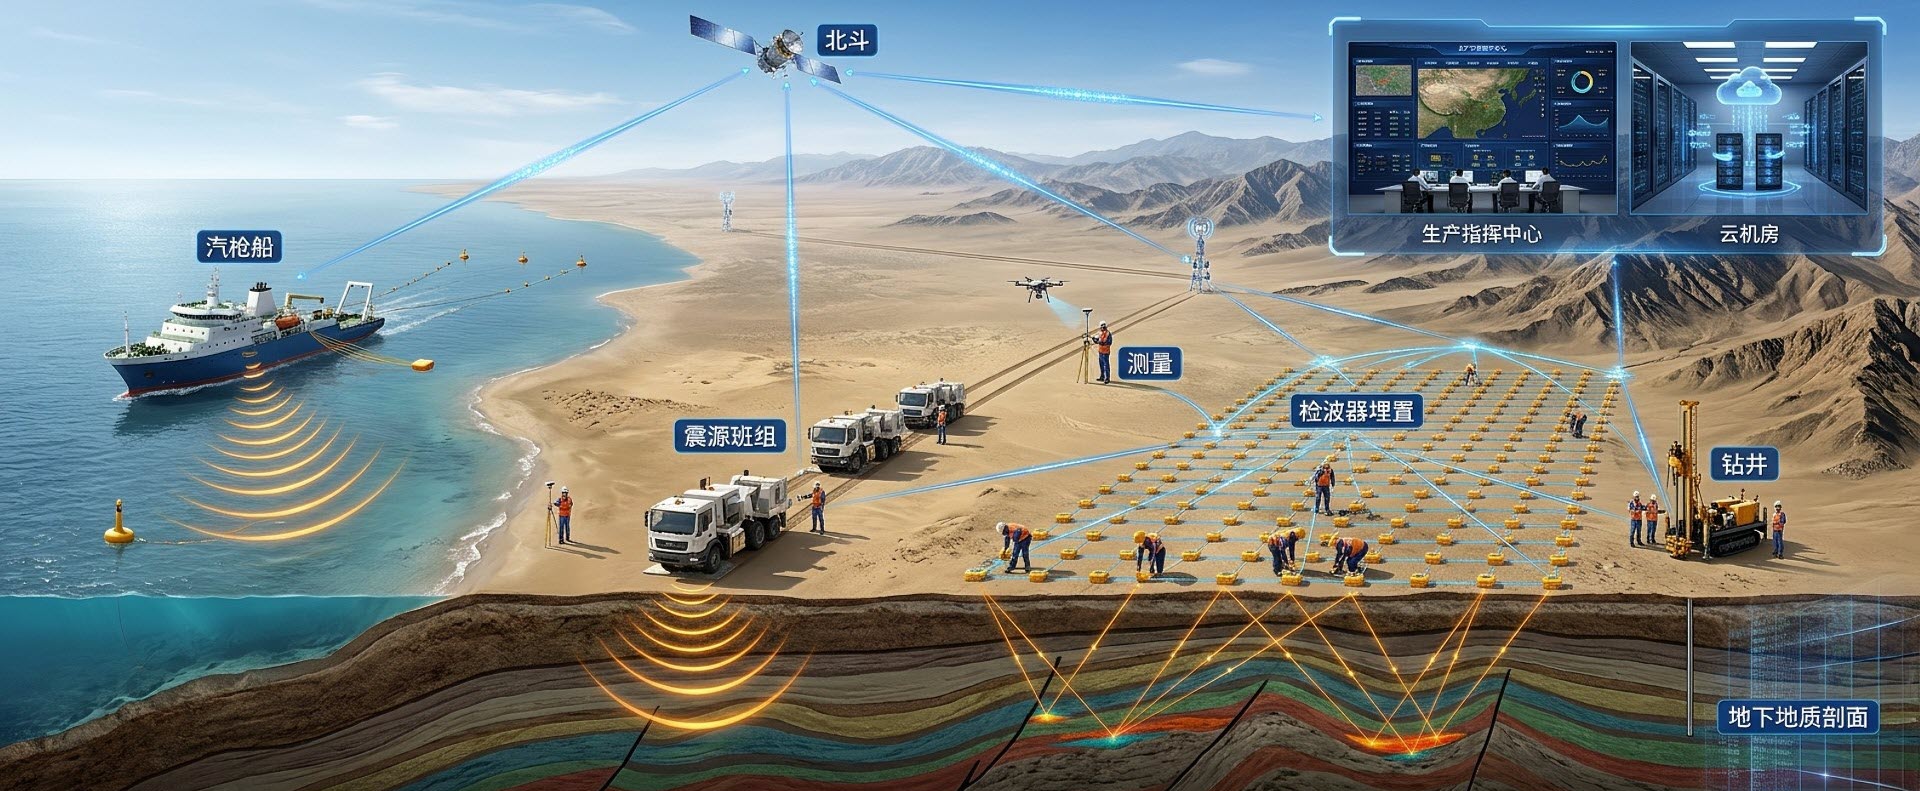
地球物理公司的主营业务是地震勘探采集。地震队在野外用炸药、震源、汽枪等激发地震波,检波器接收反射信号,再处理成像,服务找油找气。
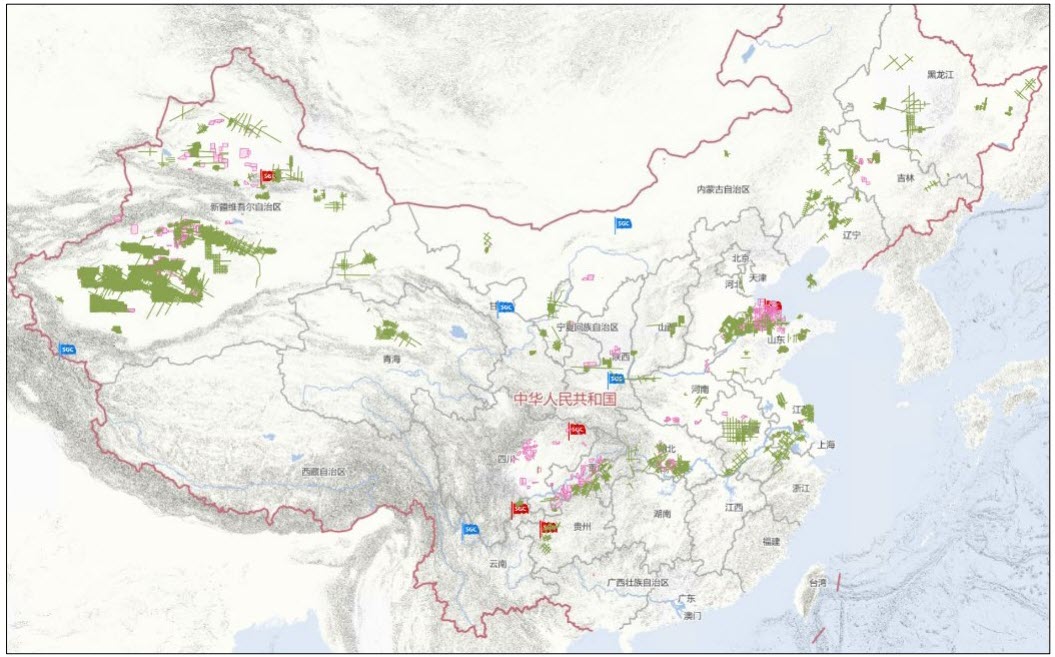
公司的勘探工区遍布国内外,数十年下来,积累了海量项目档案,文档格式以 DOCX、PDF、PPT、XLSX 为主,包含工程技术设计书、施工设计书、工区踏勘报告、测量技术设计 / 总结、野外试验方案 / 总结、施工总结等。
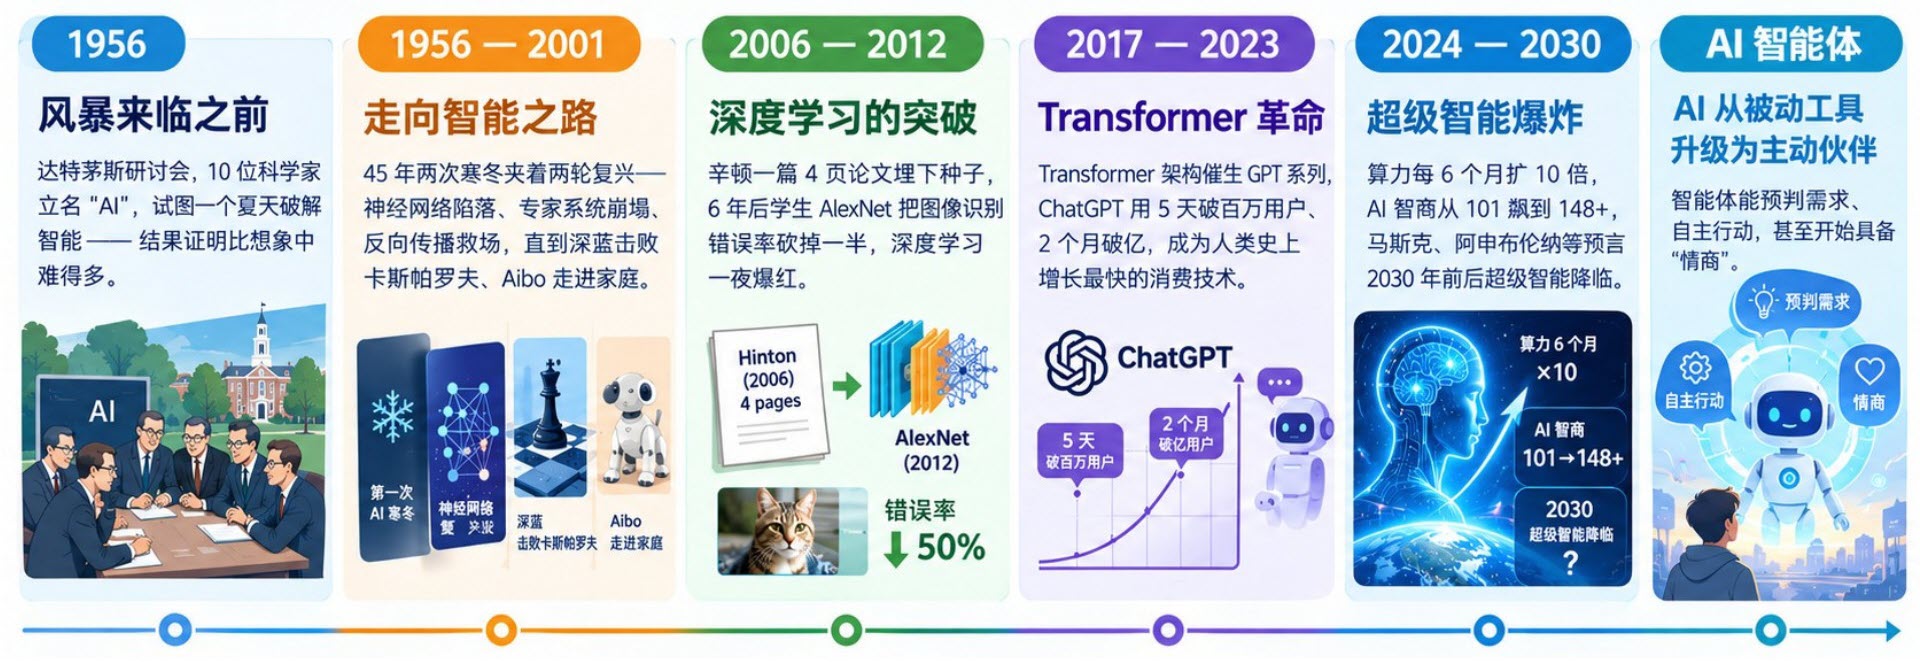
近年来,AI 浪潮席卷各行各业,Transformer 架构一统天下,大语言模型(LLM)已经能“听懂人话、说人话”。把这些沉睡的项目档案盘活,让一线技术人员用自然语言检索,是本文的重点研究内容:依托 LLM 的能力,改造传统的知识检索、问答与内容生成。
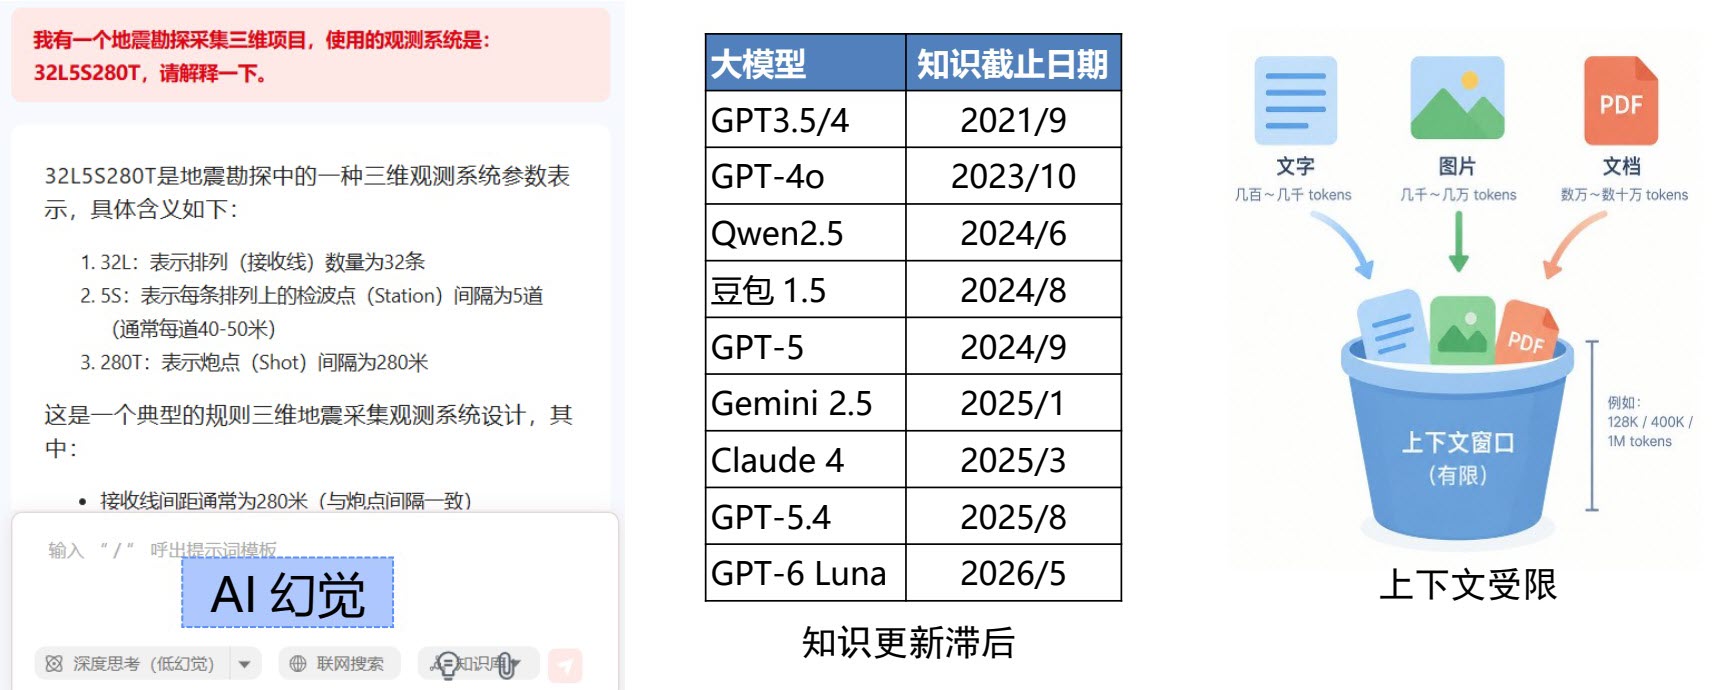
RAG(Retrieval-Augmented Generation,检索增强生成)的提出,是为了解决 LLM 应用的三个痛点:
- AI 幻觉:不管模型能力有多强,还是会“一本正经地胡说八道”;
- 知识更新滞后:训练数据都有截止时间,GPT-6刚刚发布,知识库也是半年前的,问最近的事件它也不知道;
- 上下文受限:当前能力强的大模型,上下文能到 1M,可以吃进去一整部《红楼梦》,但仍装不下成千上万份物探报告。
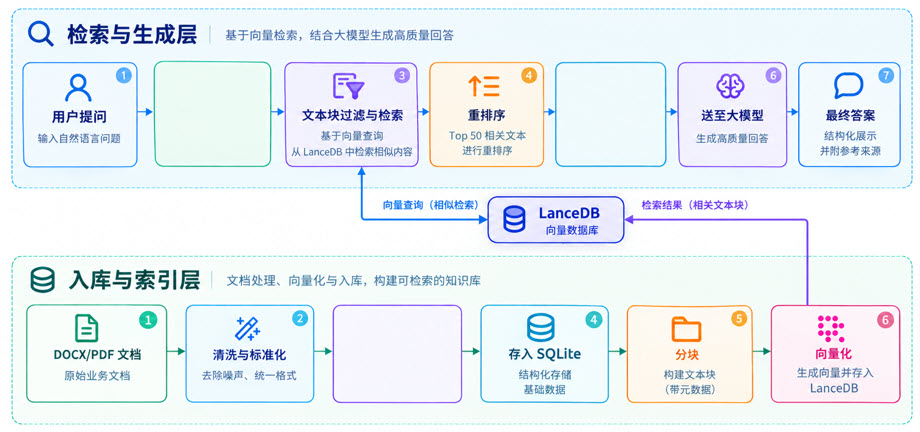
传统 RAG 分两层。从下向上来看。
下层是入库与索引层:原始文档经过清洗和标准化后存入关系数据库,再被分块、向量化存入向量数据库;
上层是检索与生成层:根据用户提问,从向量库召回 Chunk,重排序,送至 LLM 得到最终答案。
二、改进 RAG 流程
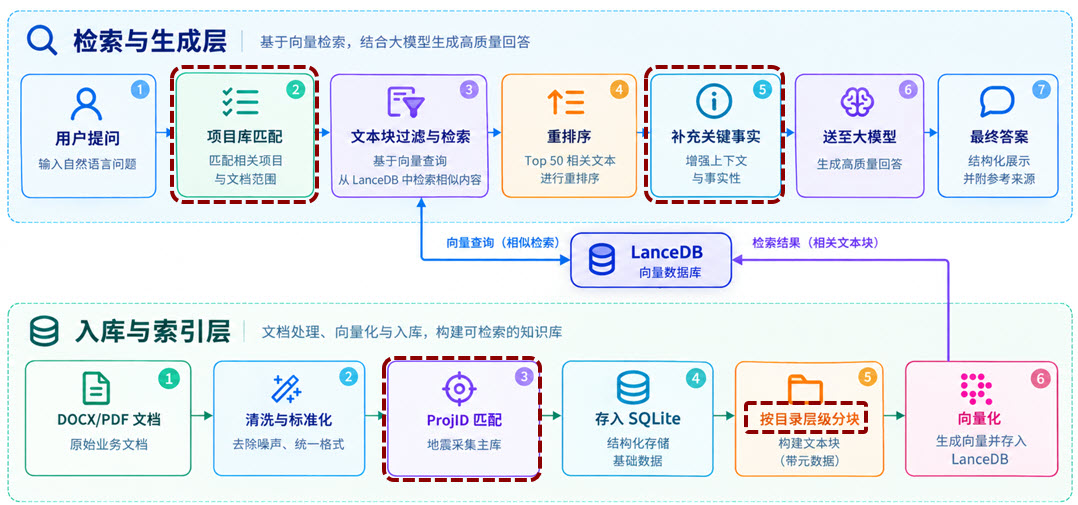
针对物探文档的特点,我们主要做了四点改进:
- 入库层增加 ProjID(项目编码,Project ID) 绑定;
- 分块采用 按目录层级 的分块算法;
- 检索层先按 项目 ID 过滤;
- 送至 LLM 之前 补充关键事实(文档封面元数据)。
2.1 入库与索引层
1)清洗与标准化
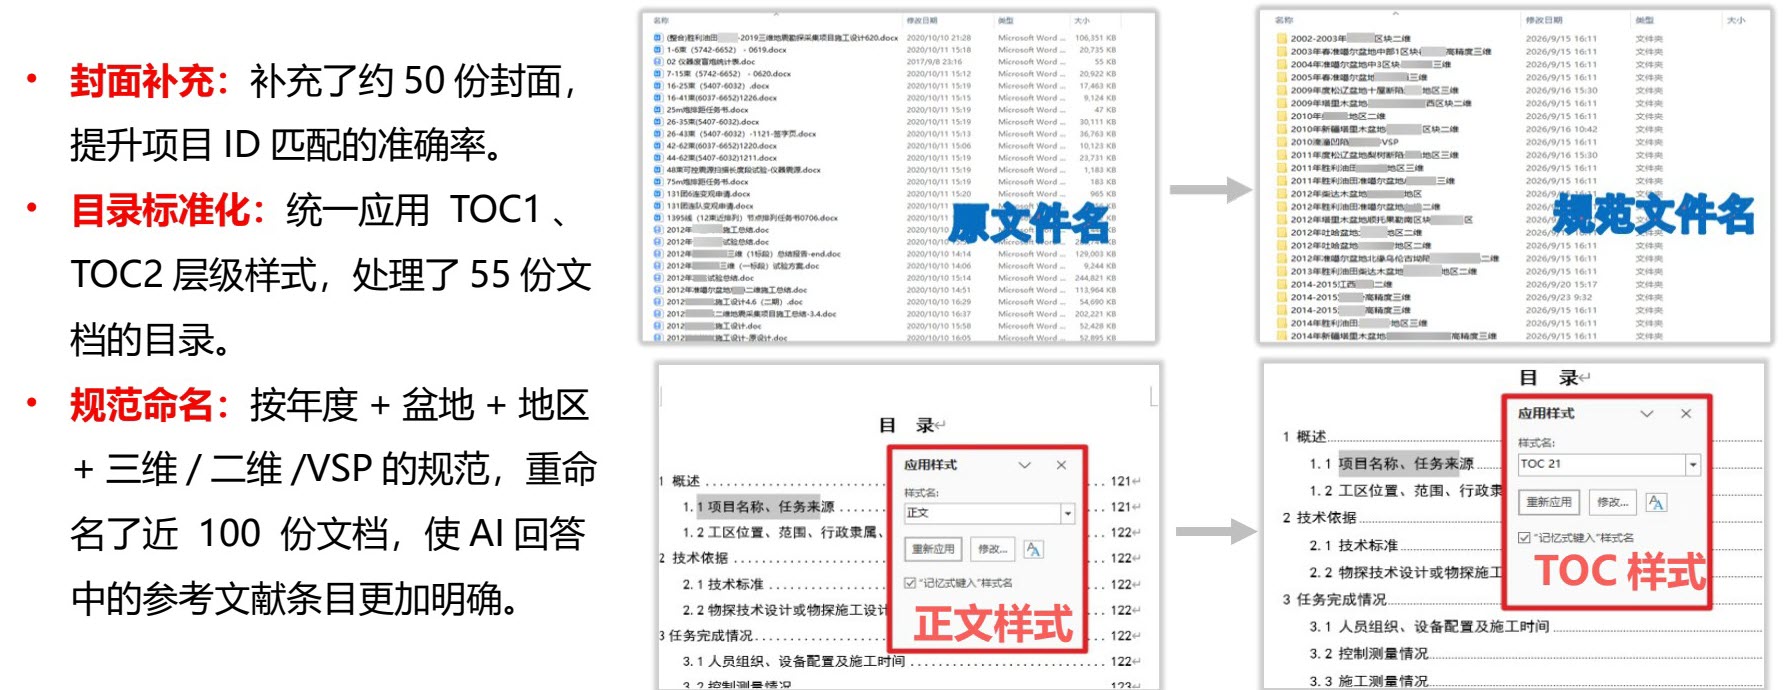
数据质量对RAG效果影响非常大——“进去的如果是垃圾,不可能期望它吐出来黄金”。我们主要做了三项治理工作:补全封面、统一目录样式、规范文件命名,当前整理形成了 455 篇标准化物探文档。
2)ProjID绑定
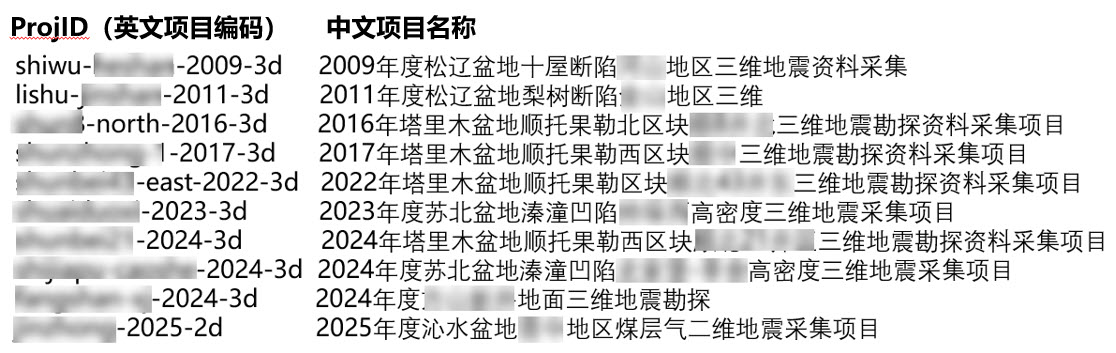
地震项目文档有一个共同的特点,它们都是某个项目生产过程的产物,可以与项目编码ProjID唯一关联。这一思路对科研项目、合同文档、标准文档同样适用。
3)存入关系数据库
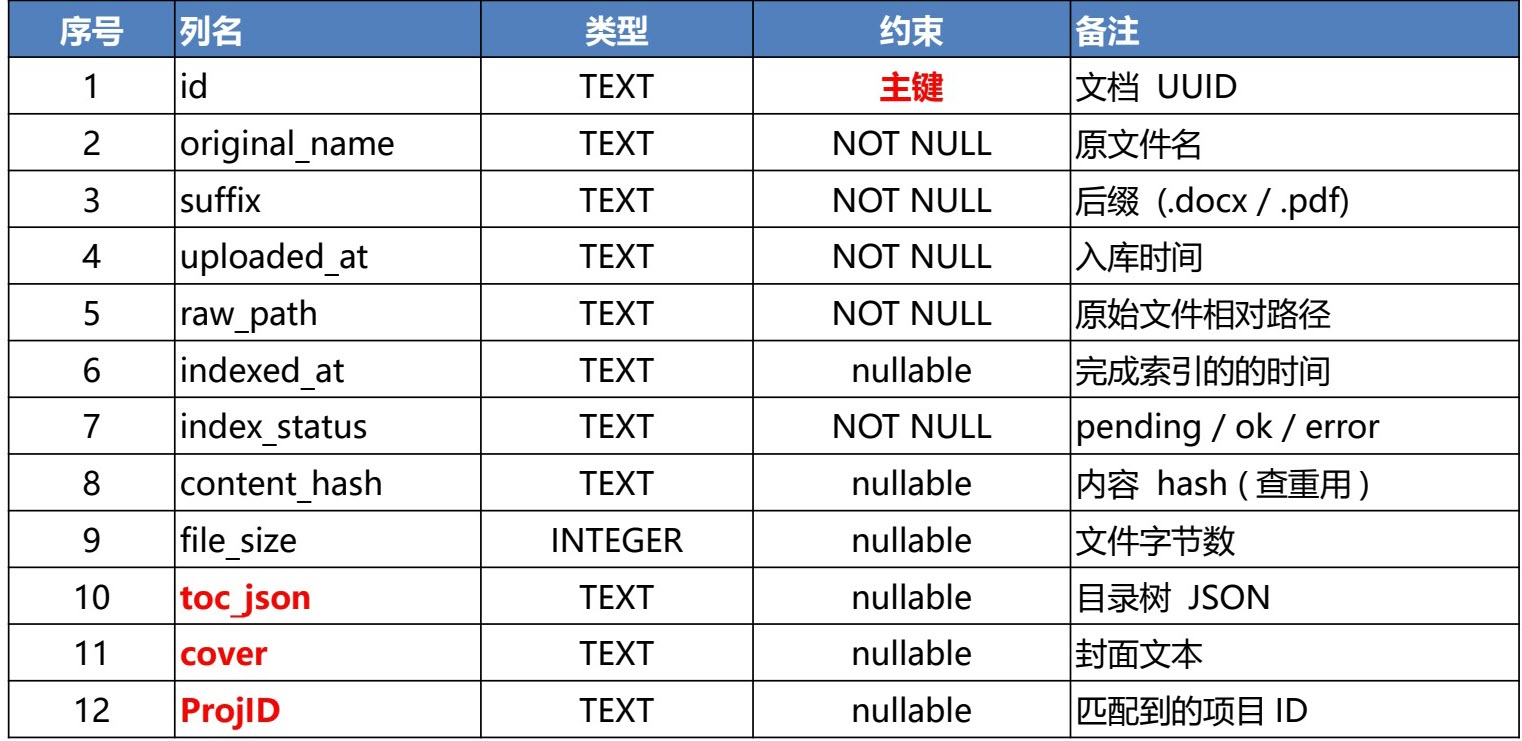
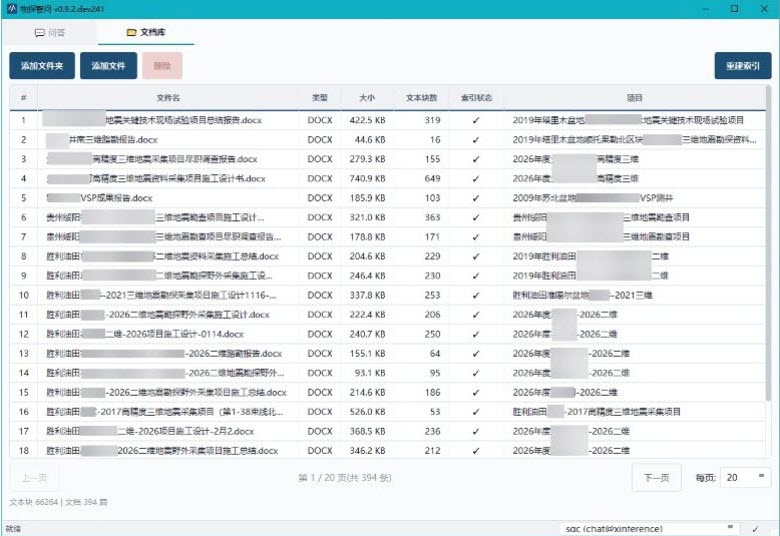
ProjID 绑定后,把元数据存入关系数据库;系统里最主要的一张表是 Documents,包含 DOCX、PDF 等。
4)按目录层次分块
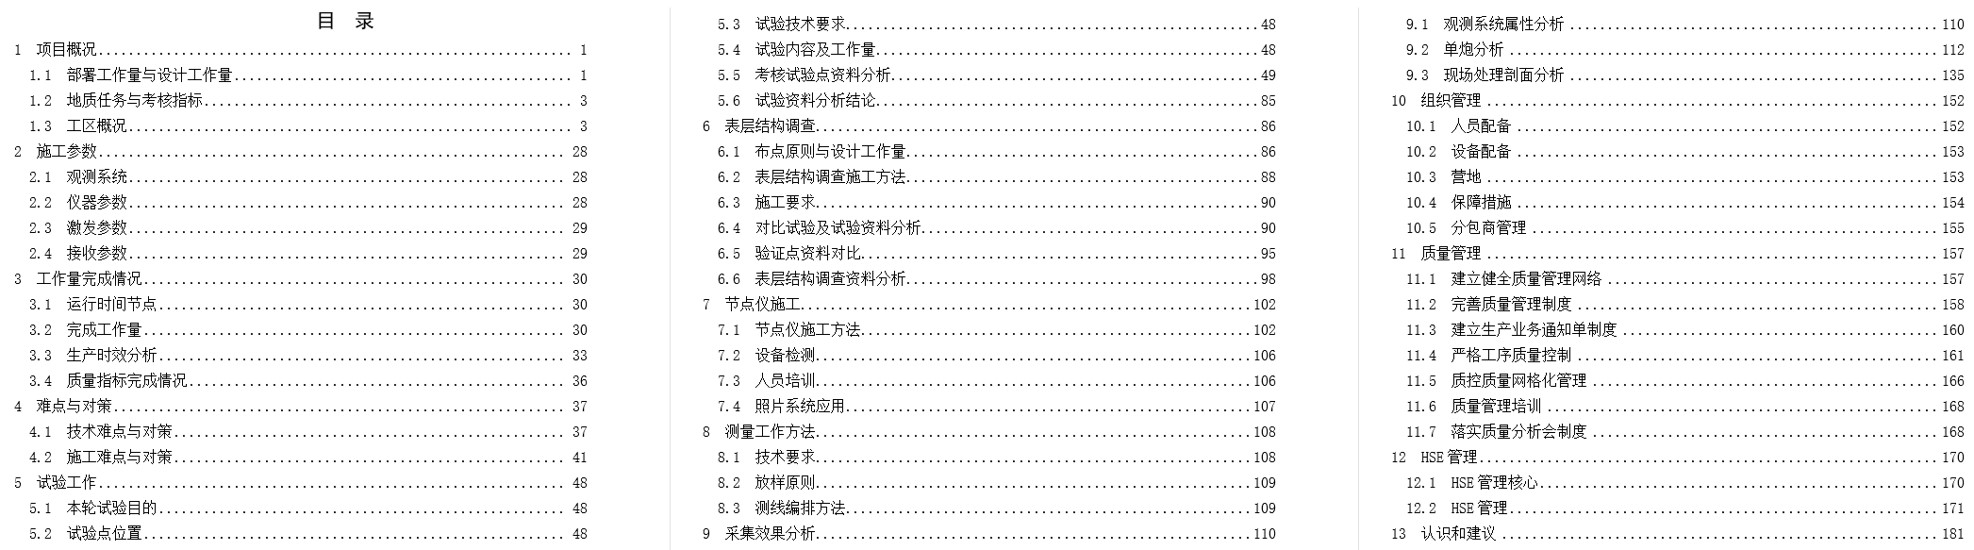
物探文档通常具有层次清晰的目录结构。我们用 python-docx 提取 TOC 样式,定位一、二、三级标题,按 (chunk_chars, overlap) = (400, 60) 分块。
把目录层级拼到 chunk 文本前面,进行嵌入向量的计算,例如:“2 施工参数 → 2.1 观测系统 → 2.1.1 排列方式”,会变为“施工参数 → 观测系统 → 排列方式”,放在chunk之前进行向量化。
表格用 Markdown 表示,按 8000 字符截断。
5)向量库存储
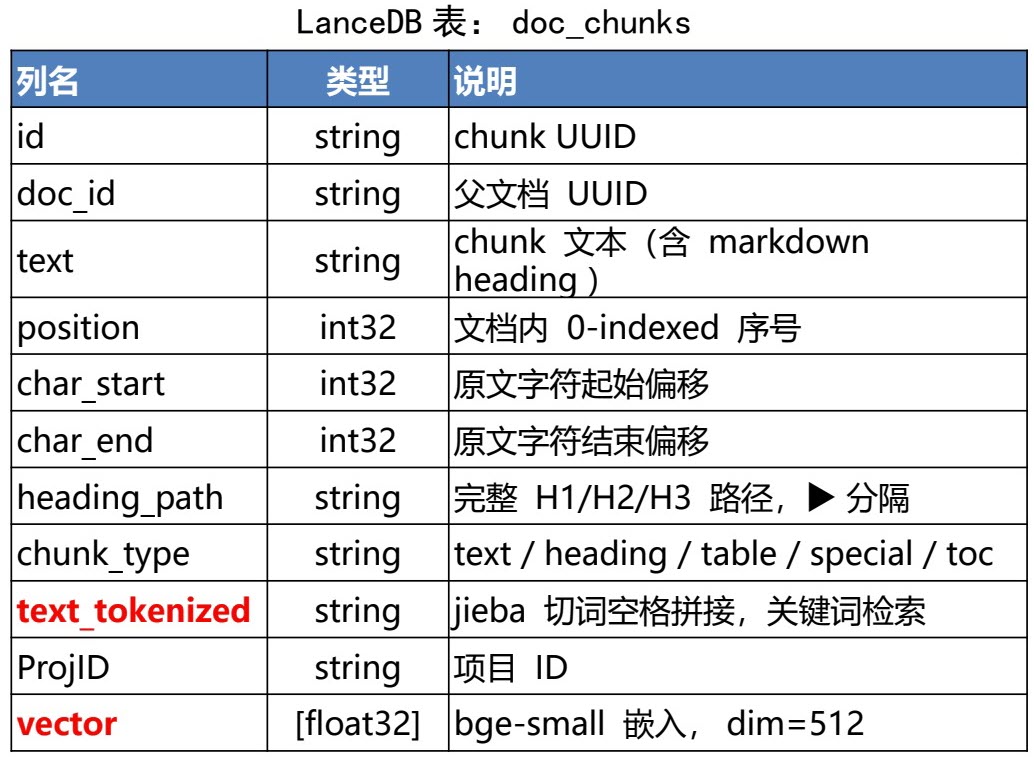
向量库使用 LanceDB,嵌入采用 FastEmbed + BGE-small-zh-v1.5:512 维、INT8 量化、90 MB、纯 CPU 可跑。
使用jieba 分词 + BM25 提取形成 text_tokenized 字段,用于后续混合检索。
2.2 检索与生成层
1)项目库匹配
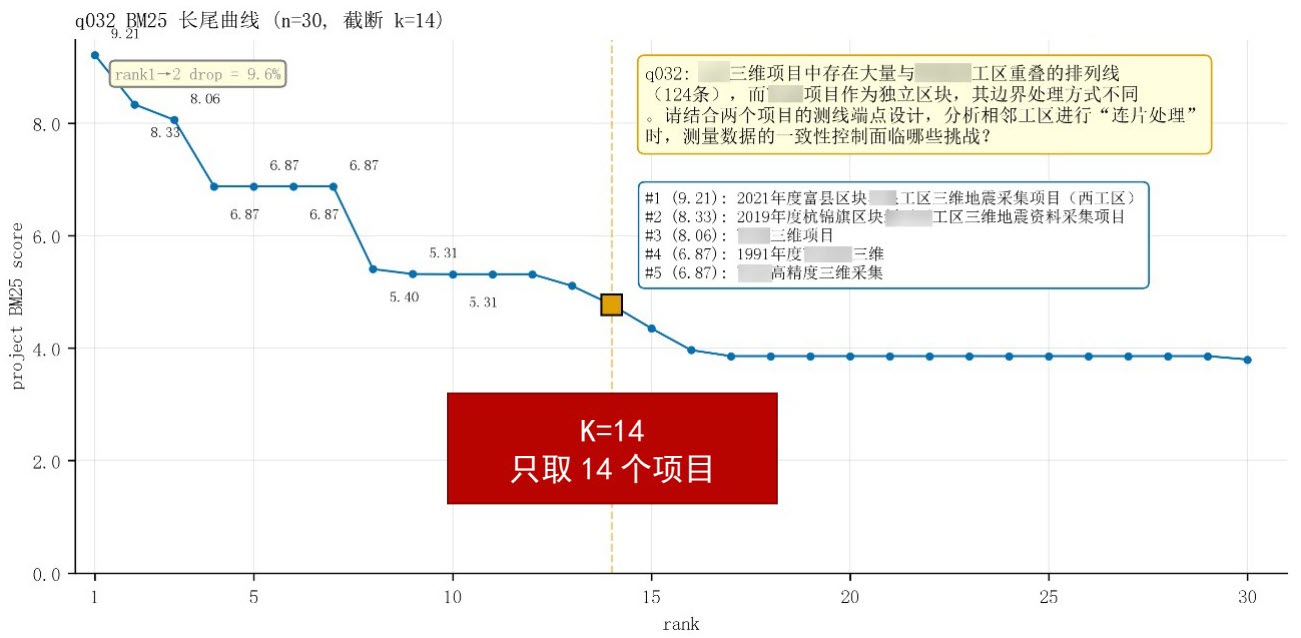
对用户问题做 BM25 关键词打分,与项目库 2200 多个项目名称进行匹配。以 top1 为基准,低于 top1 × 0.5 的项目过滤掉,最多保留 30 个候选项目。
2)混合检索
LanceDB 内置混合检索,稠密向量(语义)部分占 80%,BM25 关键词部分占 20%,两路使用 MRR Reranker(Reciprocal Rank Fusion)加权融合,最多召回 150 条 chunk。
chunks_150 = LanceDBStore.hybrid_search(
    query_vec  = embed(query), #向量
    query_text = query,        #BM25
    where ProjID IN proj_ids,
    top_k      = 150,
    reranker   = MRRReranker(
        weight_vector = 0.8,
        weight_fts    = 0.2,
    ),
)
3)精排
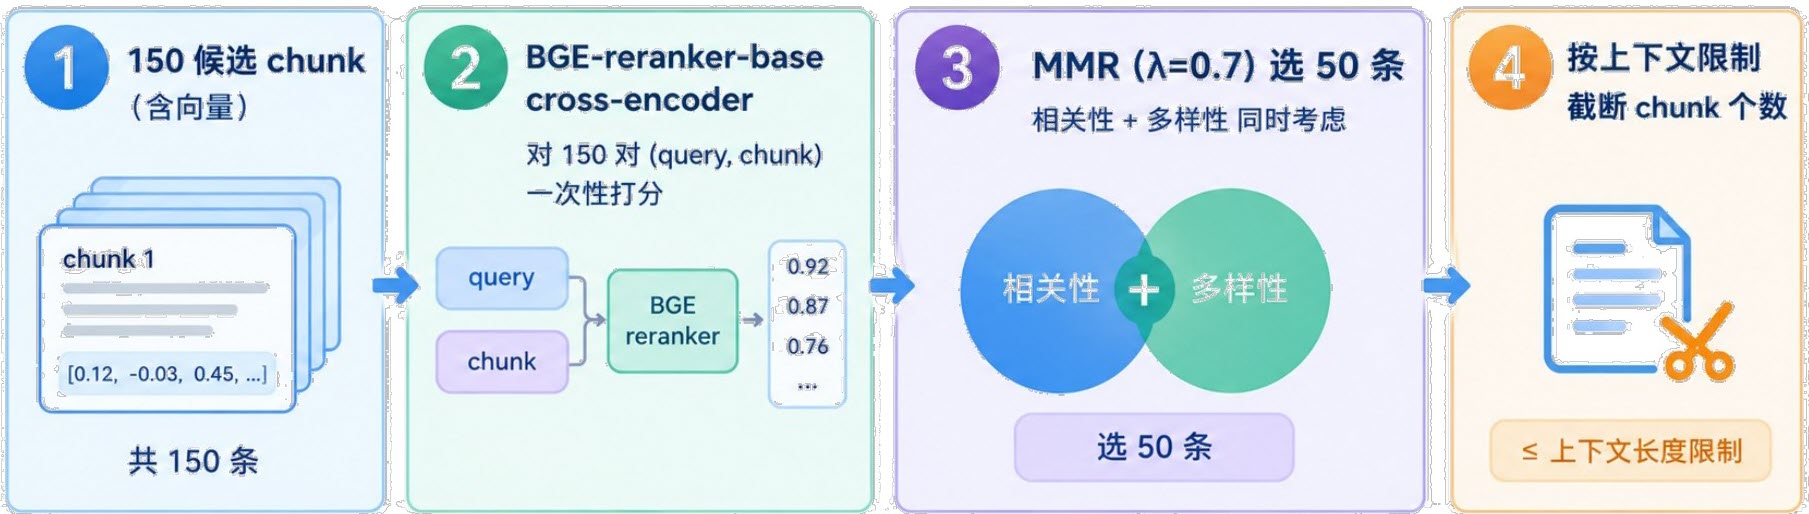
用 Cross-Encoder reranker 对 150 条 chunk 一次性打分,再用 MMR(Maximal Marginal Relevance,λ=0.7)兼顾相关性与多样性选出 50 条;上下文控制在 32K 以内。如果 LLM 上下文更短(例如 Qwen3.8-27B 上下文 16K),需再次截断(例如控制在 25 条以内)。
4)补充关键事实
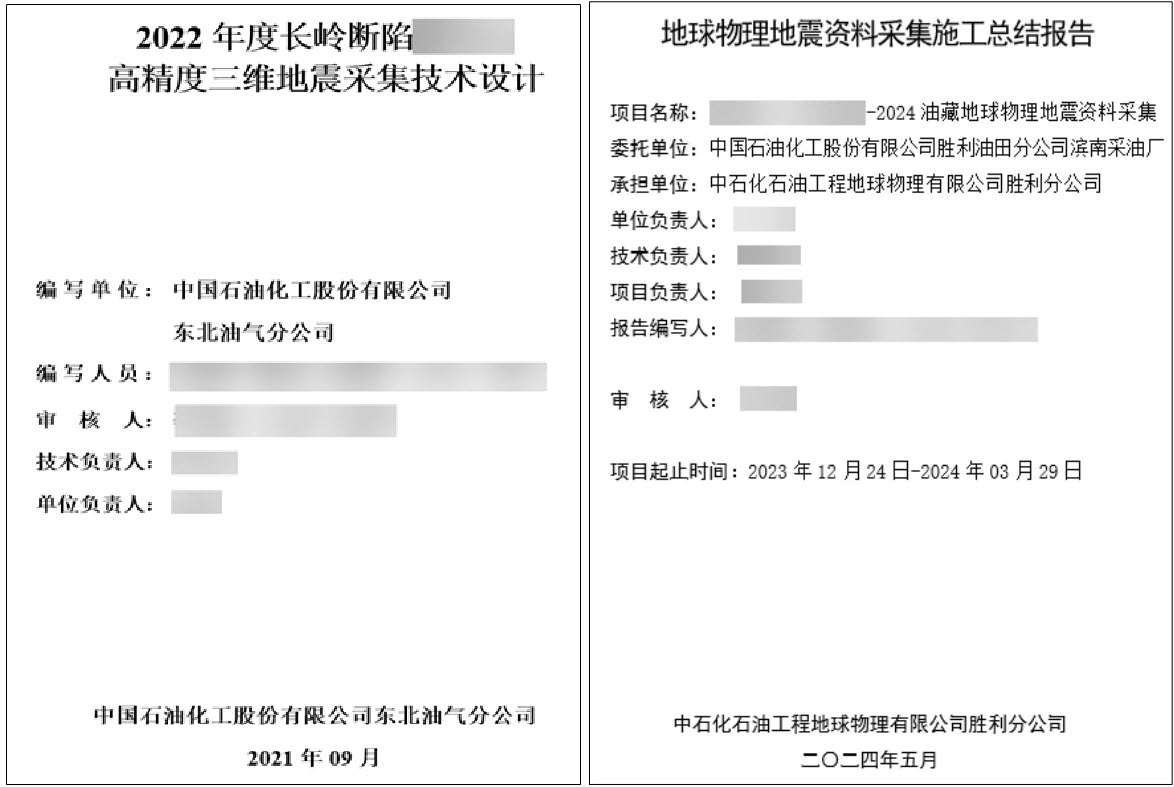
文档封面(目录之前)包含项目名称、甲方 / 乙方单位、负责人、编写人员、施工队号、编写日期、起止日期等元数据;30 条 chunk 平均来自 10 篇文档,将元数据补全后再送 LLM,能补上一些关键信息。
5)送 LLM
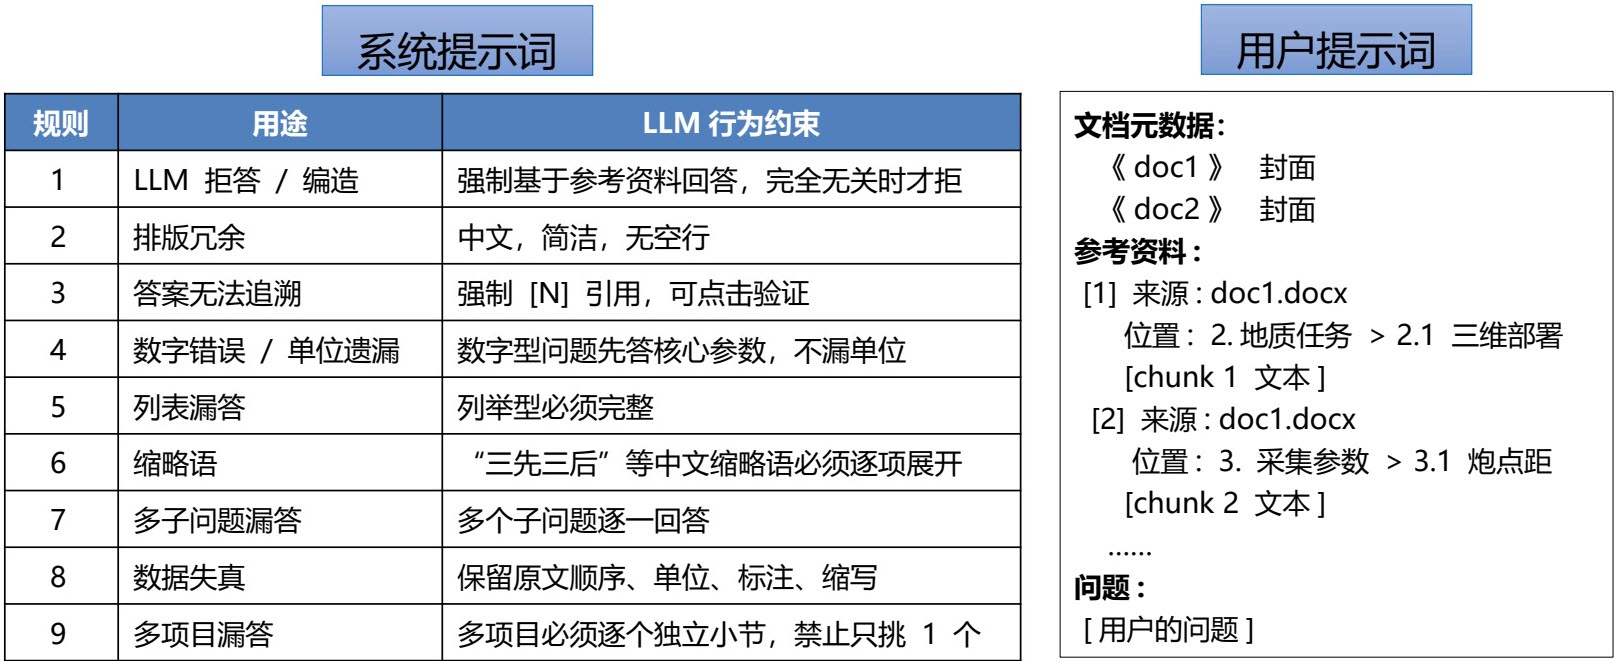
提示词按系统提示词 + 用户提示词组合。系统提示词规定回答风格、参考文献引用、数字单位、缩略语处理等原则;用户提示词包含具体问题、文档元数据、参考资料(每条参考资料标出来源文档、目录位置与 chunk 文本)。
三、软件设计实现
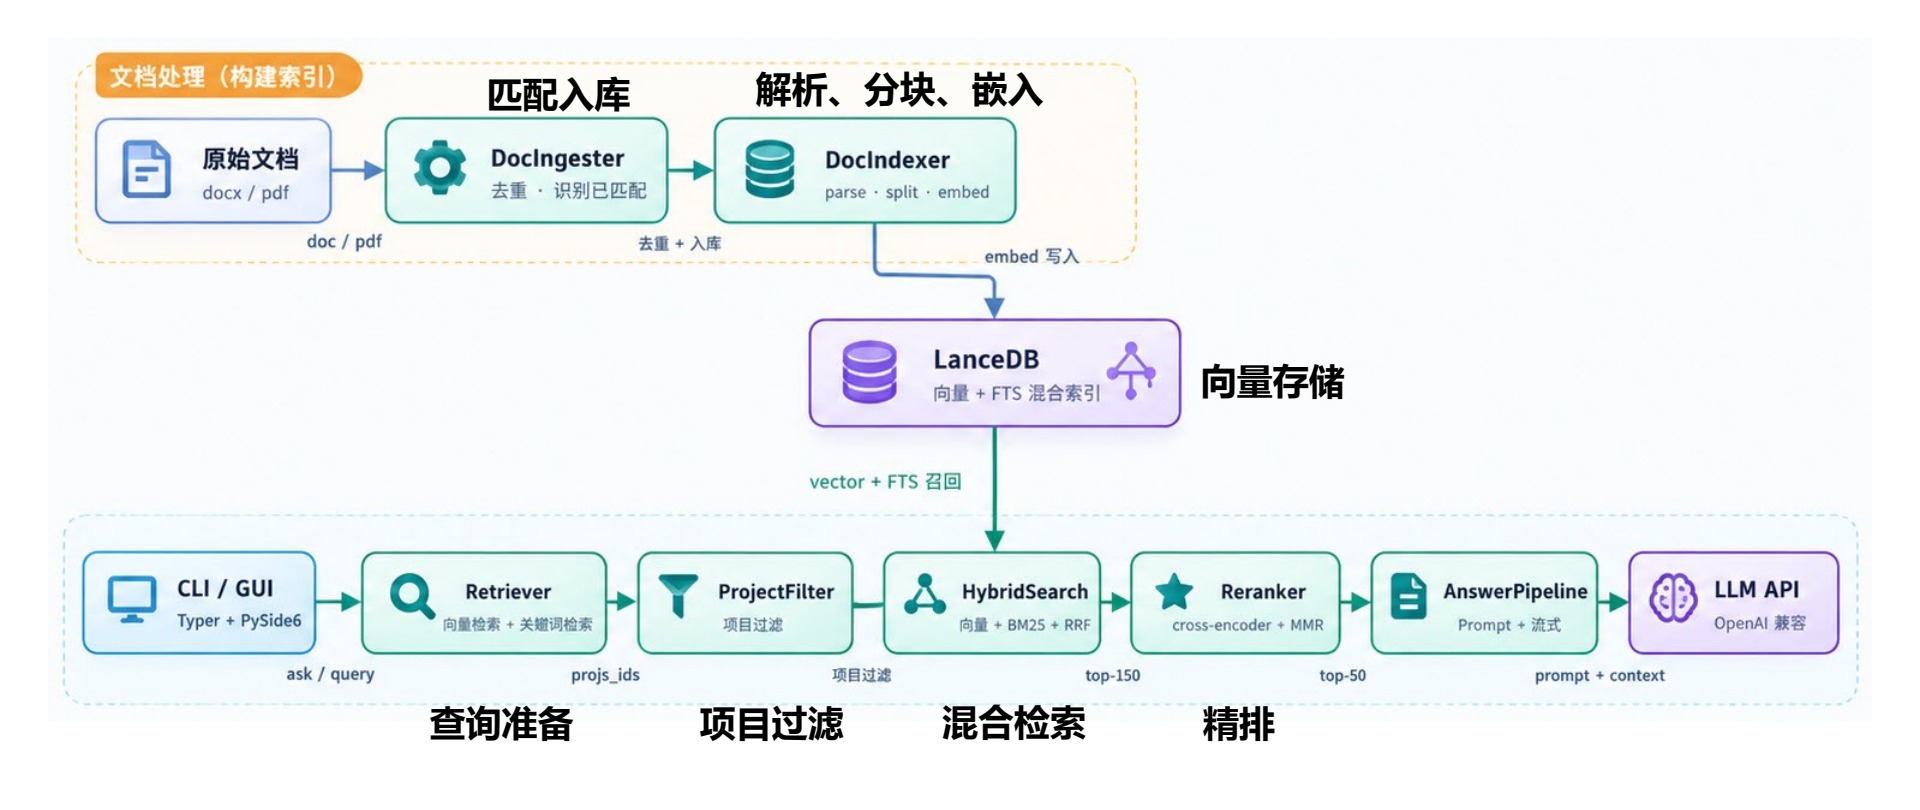
软件实现的主要类和模块见下图。关键模块包括:匹配入库、解析 / 分块 / 嵌入、向量存储、查询准备、项目过滤、混合检索、精排等。
3.1 设计要点
- Python ≥ 3.11,不依赖 LangChain / LangGraph;
- 文档解析仅使用
python-docx和 PyMuPDF,覆盖 DOCX 与 PDF; - jieba ≥ 0.42 分词,增补 180 个物探领域词汇(观测系统、检波器、激发点等),BM25 检索准确率明显提升;
- 向量库使用 LanceDB,原生支持稠密向量 + BM25 混合检索,单文件夹存储;
- 文档数据库:技术验证用 SQLite,生产环境换 PostgreSQL;
- 嵌入:FastEmbedder + BGE-small-zh-v1.5(512 维、INT8、90 MB、纯 CPU);
- 精排:BGE-reranker-base(INT8、266 MB),cross-encoder 一次性对 query + chunk 联合编码,比双塔更准;
- LLM:测试用 MiniMax-M2.7,生产环境用内部 Qwen3.8-27B 与长城大模型 DeepSeek-V4-Flash;
- 客户端:主要使用CLI,用于快速技术验证,GUI 用 PySide6 快速实现,整个软件的开发过程借助 Claude Code 实现。
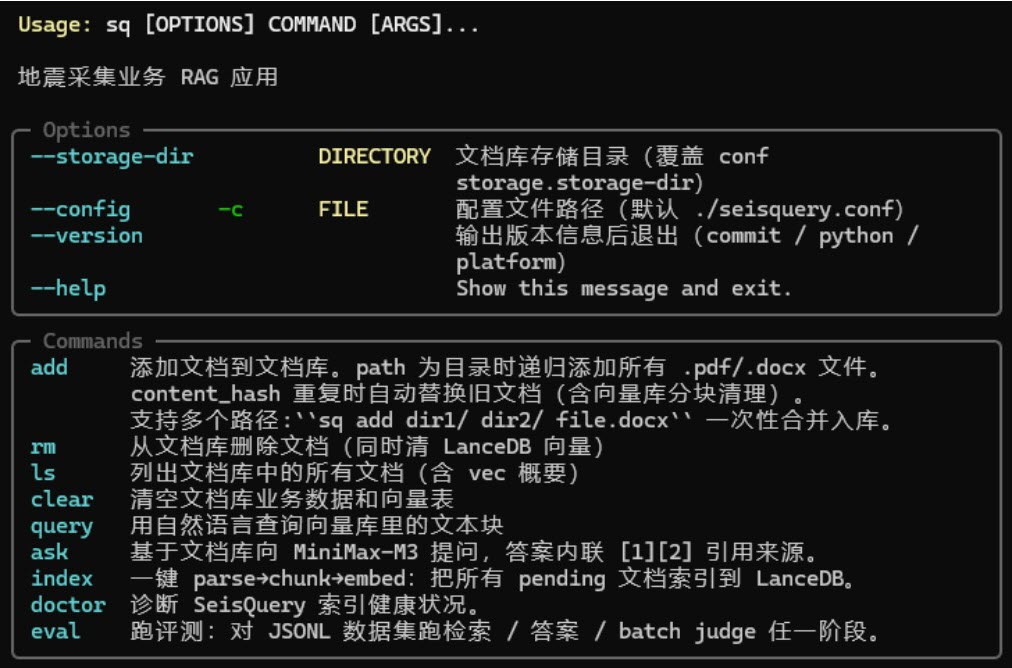
3.2 命令行界面(CLI)
由于 Vibe Coding 流程,CLI 是日常使用的主要入口。常用命令:
add / rm / ls:添加、删除、列出文档;clear:清空文档库、向量库;index:重新分块、重建向量索引;query:检索,只查不答,用于检查召回效果;ask:检索 + LLM 生成答案;eval:对 JSONL 测试集批量跑题,并用第三方 LLM 评分,用于回归测试。
3.3 技术验证阶段
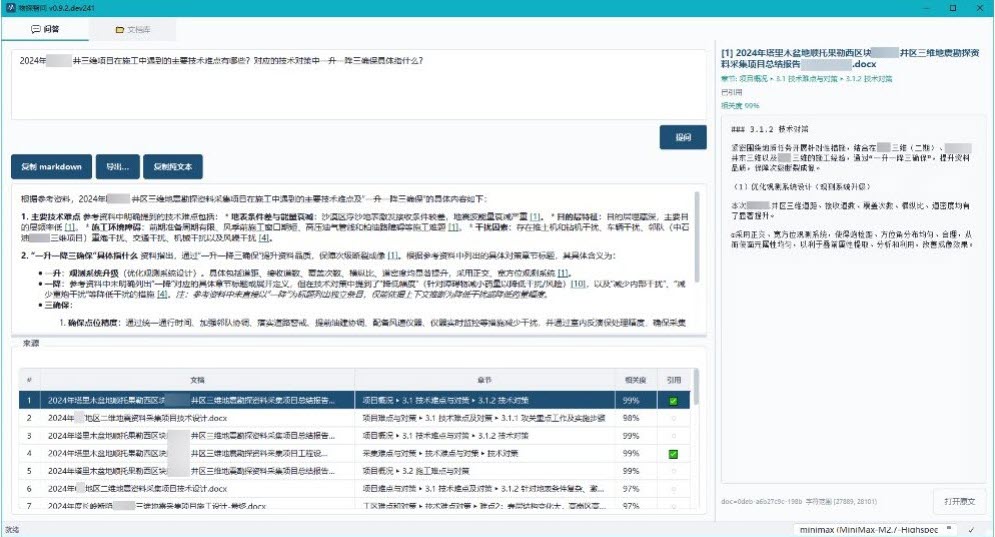
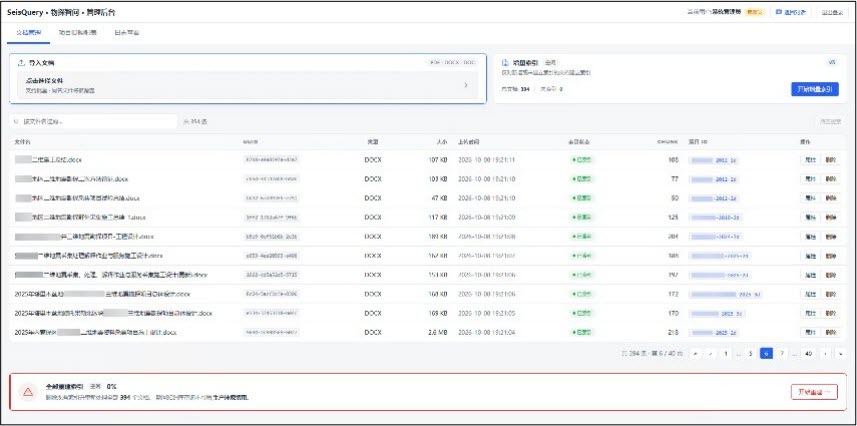
技术验证阶段借助 Claude Code 辅助编程,几乎所有操作都在本地完成、纯 CPU 运行,仅 LLM 调用需要联网。数据库使用 SQLite 单机即可,用 PySide6 构建桌面应用进行快速迭代。
3.4 内网生产环境部署
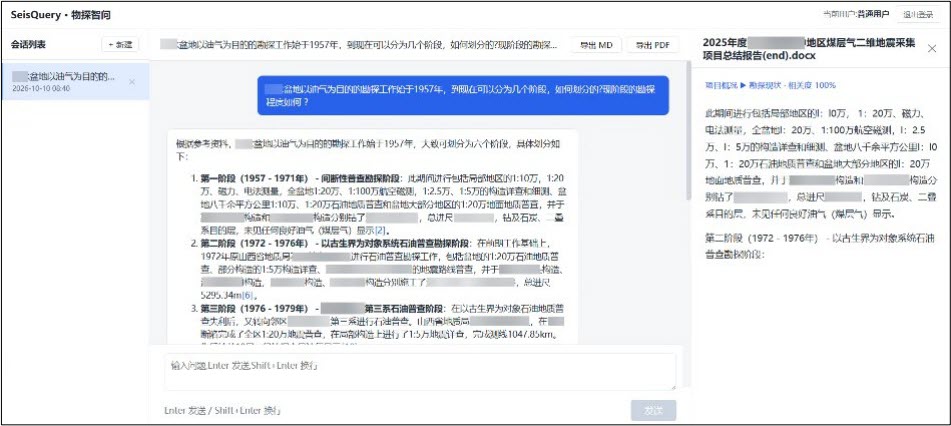
生产环境中为支持多用户访问,关系数据库替换为 PostgreSQL。服务端用 Python 3.11 + FastAPI + LanceDB + FastEmbed 构建,客户端用 Vue 3 + Pinia + Vite 构建网页程序,LLM 接入中石化长城大模型 DeepSeek-V4-Flash。
3.5 对比评测
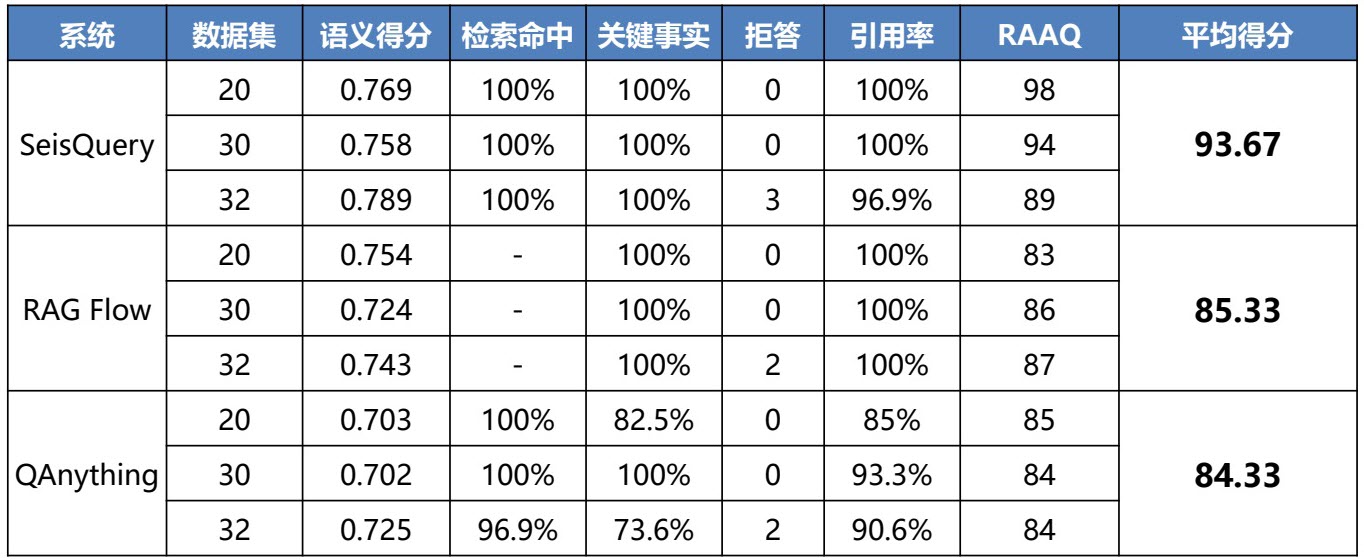
基于 26 份物探业务文档、人工标注 82 道测试问题(分data20, data30, data32三组),对 SeisQuery(物探智问)、RAG Flow、QAnything 三套 RAG 系统做对比评测。评分采用 RAAQ:llm_judge × 80% + chunk_recall × 20%,百分制。SeisQuery 平均 93.67 分,比 RAG Flow(85.33)和 QAnything(84.33)高 8~9 分。
四、结论与认识
围绕"够用、可量化、快速落地"的项目目标,我们在实践过程中有三点认识。
1)数据质量是 RAG 的基础
物探文档天然带有 ProjID 和层次清晰的目录结构,把时间花在数据清洗上是回报比较高的工作。
2)不必盲目追逐最新大模型
BGE-small-zh-v1.5 量化版只有 90 MB,纯 CPU 可跑,配合“目录层级分块 + 语义/BM25 混合检索 + 项目库过滤 + 文档封面元数据补全”这套组合,在这个场景下基本够用。
3)可量化的评测驱动迭代
手工标注了 82 道评测题,建立了 RAAQ 评估体系,每次修改参数都把评测完整跑一遍,及时了解每个微小改动带来的效果变化。
五、未来工作
在 SeisQuery 已落地的能力之外,还有三个方面值得深入:
1)多模态大模型应用
文档报告里还有大量图件,如地震剖面、构造图、观测系统图等,这些都没有嵌入分析,下一步引入多模态大模型的能力,可以做图件检索与综合分析。
2)表格数据综合分析
报告中常附加大量的炮检点、试验点数据表,下一步结合 TXT2SQL 等技术,支持自然语言查询、统计分析这些结构化数据。
3)智能体 RAG 应用
当前只做自然语言的问答,下一步需把这个能力封装为 Skill,研究基于 DeepSeek Harness 框架的长上下文、多轮交互智能体应用。